Voy a muchos eventos sobre programación, ya todos son sobre IA, y siempre me doy cuenta de la gran distancia que hay entre los desarrolladores que están a día de hoy en la punta de lanza, usando los últimos modelos, y los desarrolladores normales.
Todos sabemos cuánto han avanzado, a día de hoy, los modelos frontera, pero no todos los desarrolladores le han dedicado el suficiente tiempo a experimentar con ellos y con los modelos anteriores para realmente darse cuenta de las funcionalidades que desbloquean estos.
Hace años hablábamos de que existían unos desarrolladores que eran los desarrolladores 10x. Era ese desarrollador que te podía llegar a sacar el trabajo de 10. A día de hoy ya se está hablando de los desarrolladores 100x. La única forma de conseguir esto es a través del uso eficiente de modelos frontera.
La mayoría de los desarrolladores están usando modelos de IA y no saben realmente las capacidades de cada modelo que están usando porque no han vivido cada uno de los cambios, cada una de las versiones, y no han dedicado las suficientes horas a probarlos o ver vídeos explicándolos. A día de hoy, no existe ninguna empresa que pueda dar ninguna documentación que esté al día sobre cómo se usan estos modelos frontera de forma eficiente y pueda realmente enseñar a los desarrolladores a convertirse en el 100x directamente.
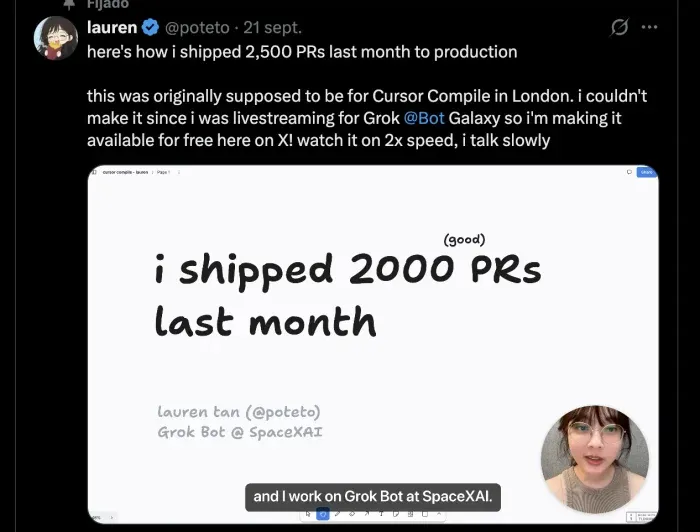 Ejemplo de desarrollador 100x
El 100% de los recursos que puede dar una empresa sobre esto están desactualizados y solo van a inducir ideas erróneas provenientes de modelos de hace meses, lo que acaba en repositorios peor preparados y agentes funcionando peor aun siendo modelos frontera.
Me atrevería a decir que más del 90% de los desarrolladores no saben aprovechar totalmente los modelos frontera, y usarlos bien cambia totalmente cómo se trabaja en programación. La seguridad que te aporta su código, el nivel de paralelización que te permiten y la velocidad que consigues no te los da un modelo menos inteligente.
La única forma de llegar a hacerse bueno es dedicándole horas a usarlos, a realizar tareas con ellos y a gastar, incluso desperdiciar, muchos tokens.
Si no eres desarrollador y aprendes a utilizar modelos de forma eficiente, puedes convertirte en un desarrollador 1x.
Si eres desarrollador, ya puedes llegar a convertirte en uno de esos desarrolladores 10x si usas de forma eficiente los modelos.
Y en algunos casos, los desarrolladores que siempre van más allá, que son early adopters, a los que les interesan las novedades y están más metidos en ello, pueden convertirse en desarrolladores 100x.
Para que tus empleados puedan hacer este upgrade, van a necesitar gastar muchos tokens.
Si tienes una empresa y no estás pagando a tus desarrolladores su mismo salario en tokens, sabiendo la mejora de productividad que no les estás permitiendo hacer, estás deliberadamente ralentizando la compañía.
Para realmente llegar a multiplicar tu productividad por 10, es necesario conocer las funcionalidades de cada modelo, saber cuándo usar un modelo frontera, cuándo utilizar los distintos niveles de razonamiento. La única forma con la que, a día de hoy, se puede aprender eso es permitiendo que puedan gastar tokens en ello.
Gracias a las suscripciones, un desarrollador puede coger un modelo frontera (como sería Fable 5.1) y probarlo sin gastarse dinero en exceso, poner el modo ultra think, mandarle una tarea que spawnee 100 subagentes y gastar el budget de tokens de una semana en un solo día. Y estará bien hecho. Es necesario y es la forma de aprender. Tienen que pasar por ahí. Tienen que utilizar los modelos frontera para poder desbloquear en su mente lo que se puede llegar a conseguir con ellos.
Mucha gente tiene en su mente las ideas de nivel agéntico que tenían los antiguos modelos. Una vez se dé el salto a modelos frontera, hay algunos errores que no se deberían cometer:
- No trabajar en paralelo con múltiples threads: mientras un agente trabaja en una tarea, en otro thread se va empezando a trabajar en otra
- No aprovechar worktrees para la paralelización
- Darles tareas demasiado cortas o sencillas
- Utilizar una terminal clásica, que complica la paralelización
- Tener un harness sobrecargado con subagentes específicos; cuanto más limpio dejes a estos modelos, mejor
- Utilizar MCPs que modifiquen el funcionamiento del harness, como utilidades de memoria o ahorro de tokens; si solo tuvieran beneficios, vendrían por defecto en el harness
- Utilizar skills o agents.md diseñadas para modelos antiguos con instrucciones innecesarias y contraproducentes en estos niveles de inteligencia
- No saber cuándo solicitar computer-use
- Pasarte de nivel de razonamiento: la inteligencia ya está en cómo se comporta el modelo, no necesitas utilizar tantos reasoning tokens para tu tipo de tarea
- Forzar la delegación en subagentes por tener contexto nuevo, en lugar de dejar que el agente los utilice para paralelizar trabajo
- Pensar que los modelos se siguen volviendo tontos al llegar a contextos altos
- Pensar que la compactación sigue siendo igual de mala que la de hace un año y pierde información
- No permitir al agente cambiar de rama, comitear y abrir PRs
- Usar Gemini
Si aplicas estas ideas con modelos menos inteligentes, intentando aumentar tu productividad, lo que conseguirás es aumentar el código de baja calidad en tus repositorios, sobrecomplicar las reviews de tus compañeros y producir errores.
Si bloqueas a tus empleados el acceso a modelos frontera por el coste que estos conllevan, les estás obligando a usar solo modelos que pueden parecer buenos por sus benchmarks. En el uso real, la gente que de verdad ha podido desarrollar ese criterio gracias a haber usado los demás modelos se ha dado cuenta de la gran diferencia que existe entre ellos, mientras que tus empleados estarían usando esos modelos pensando que son buenos, porque no les has permitido desarrollar ese criterio. Es lo que ocurre con modelos como Opus 5 o Gemini 3.8. Si no animas a tus empleados a desarrollar ese criterio, se creerán los benchmarks y acabarán desperdiciando dinero en inferencia deficiente. Una decisión que parece ahorrar dinero a tu compañía acaba empeorando y retrasando el conocimiento de tus empleados.
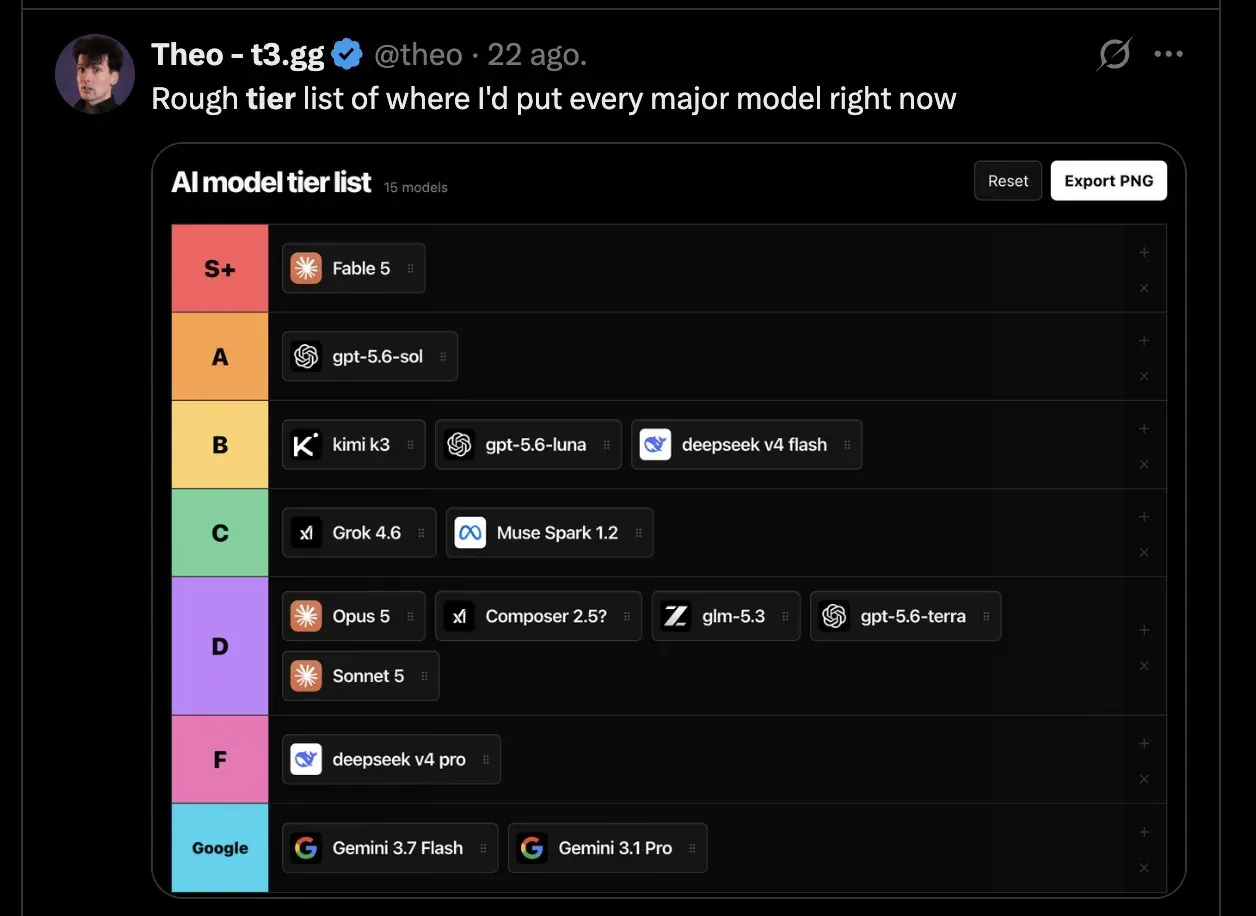
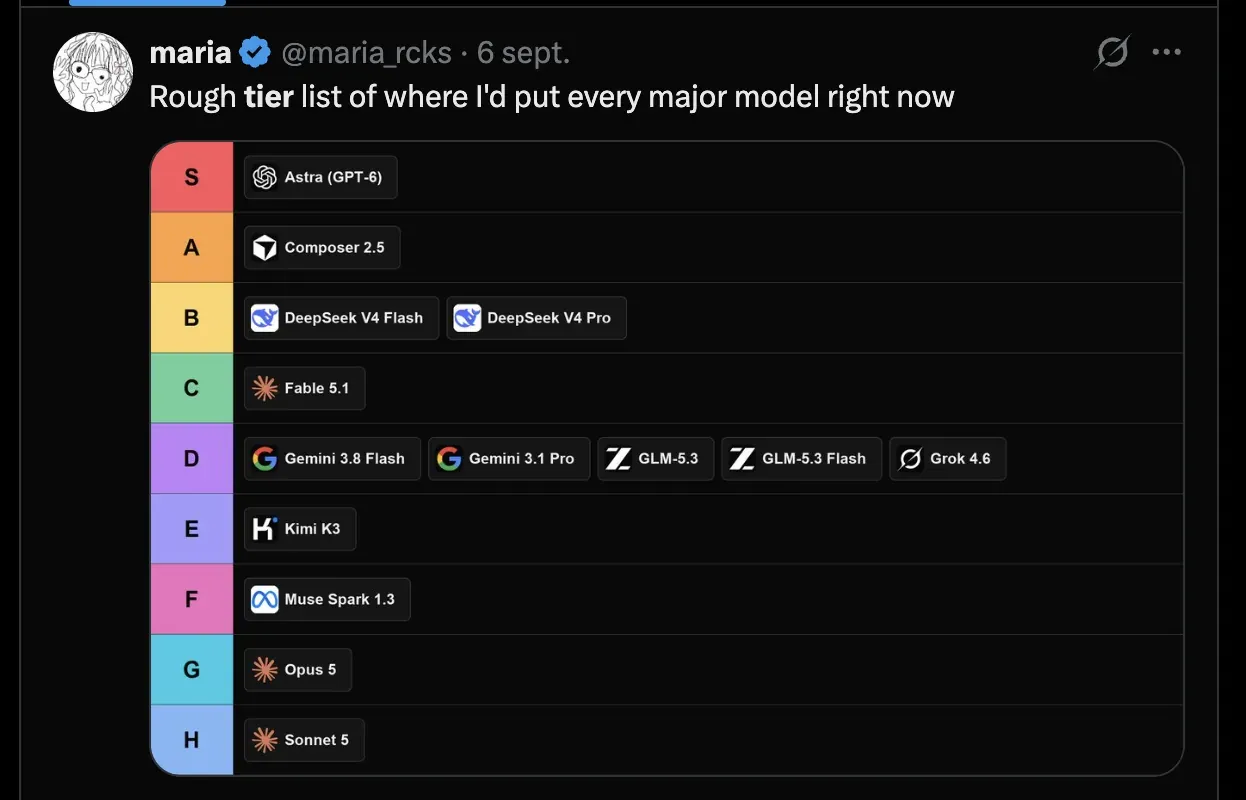
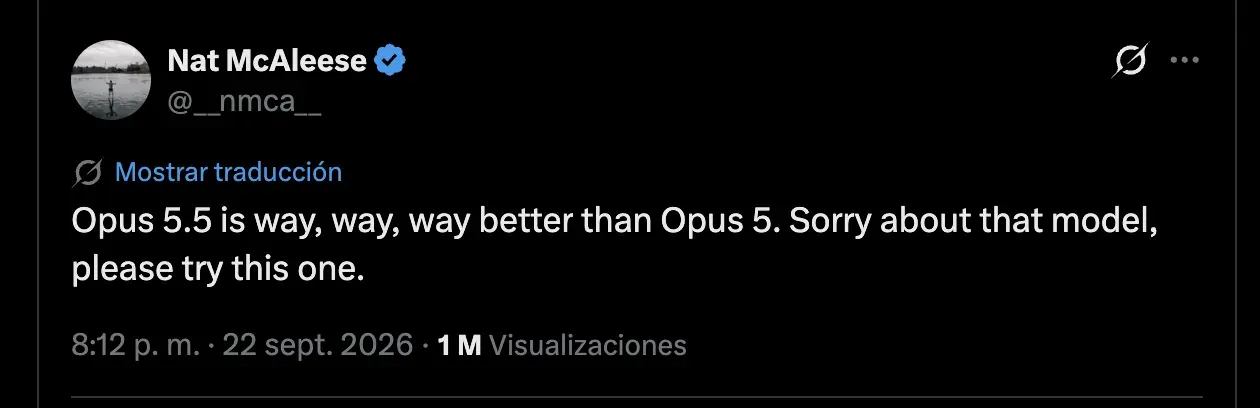
Hasta el punto de que trabajadores de Anthropic se disculparon por su modelo.
Puede que estés buscando deliberadamente retrasar la empresa: dada la velocidad de novedades en este sector, dedicar recursos a algo que puede cambiar en un mes puede ser arriesgado. Más aún si tu empresa no está compitiendo por cuota de mercado. Pero ha quedado bastante demostrado hacia dónde se dirige la industria, y no solo se utiliza para aumentar el número de features sacadas al mes: aumenta el tiempo para dedicar a seguridad, a mejoras que harías si tuvieras el tiempo necesario, a abordar deuda técnica, a mejorar el rendimiento y a aumentar la cobertura de tests. Todos los proyectos empiezan a obtener mejoras.